
Google a présenté Gemini 4 Carbon, un modèle d'IA haut de gamme axé sur la programmation, les tâches agentiques de longue durée et la cybersécurité. Google présente Carbon comme son modèle le plus puissant, mais celui-ci n'est pas encore accessible au public. L'accès anticipé est réservé à un petit groupe de spécialistes de la sécurité.
Flux de travail agentiques de longue durée et développement logiciel
Carbon est conçu pour mener à bien des tâches agentiques sur plusieurs jours, suivre l'avancement de projets complexes et produire des résultats logiciels exploitables. Google cite des exemples internes dans lesquels le modèle a poursuivi son travail pendant plusieurs jours, surmonté des blocages et remonté aux causes profondes de bugs subtils dans de vastes bases de code et des systèmes de bas niveau. Le modèle doit décomposer les problèmes en étapes plus restreintes, évaluer le résultat de chaque action, essayer d'autres approches en cas d'échec et fournir des correctifs respectant les contraintes du projet.
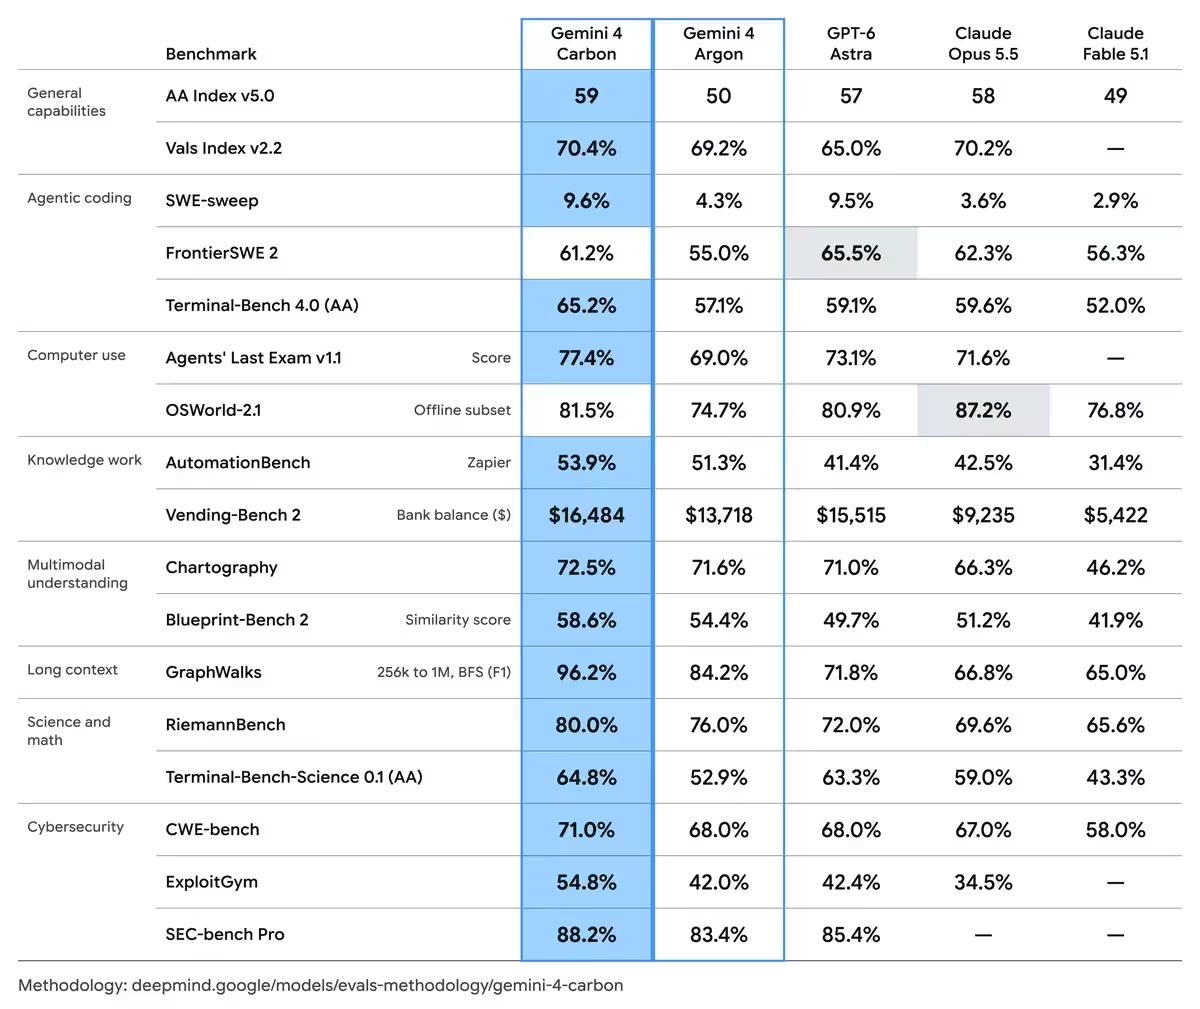
Google affirme que Carbon améliore le raisonnement scientifique, la compréhension multimodale, le développement web de bout en bout et la génération de résultats directement utilisables. Dans la version 5.0 de l'indice Artificial Analysis Intelligence, Gemini 4 Carbon a obtenu un score de 59, se classant en tête. Dans WebDev Arena, Carbon a gagné 89 points pour atteindre un score de 1769 et se classer quatrième. Google précise que cette métrique évalue la qualité des résultats en comparant des réponses directes et ne garantit pas des performances identiques dans tous les projets réels.
Cybersécurité : un processus en trois étapes et des résultats aux benchmarks
Google positionne Carbon autour d'un cycle de cybersécurité en trois étapes : identifier une véritable vulnérabilité dans une vaste base de code, en évaluer l'exploitabilité, puis produire une correction qui s'attaque à la cause profonde.
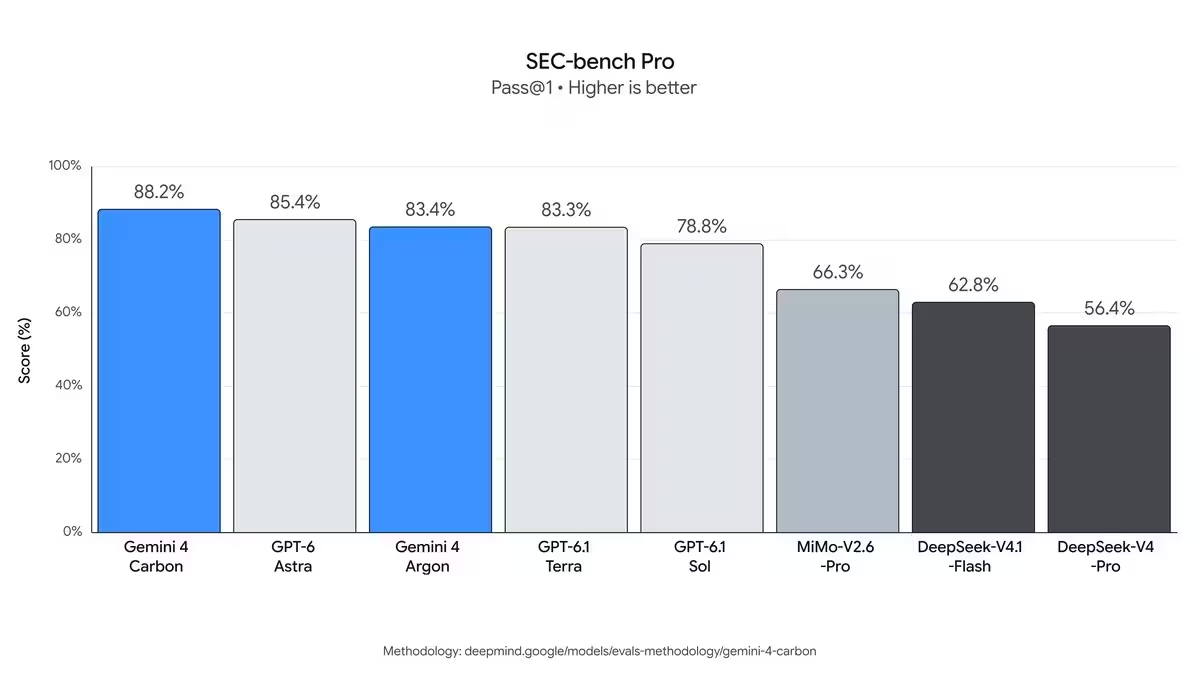
- Détection : Carbon a obtenu 88,2 % sur SEC-bench Pro, en identifiant automatiquement des défauts complexes dissimulés dans de vrais logiciels.
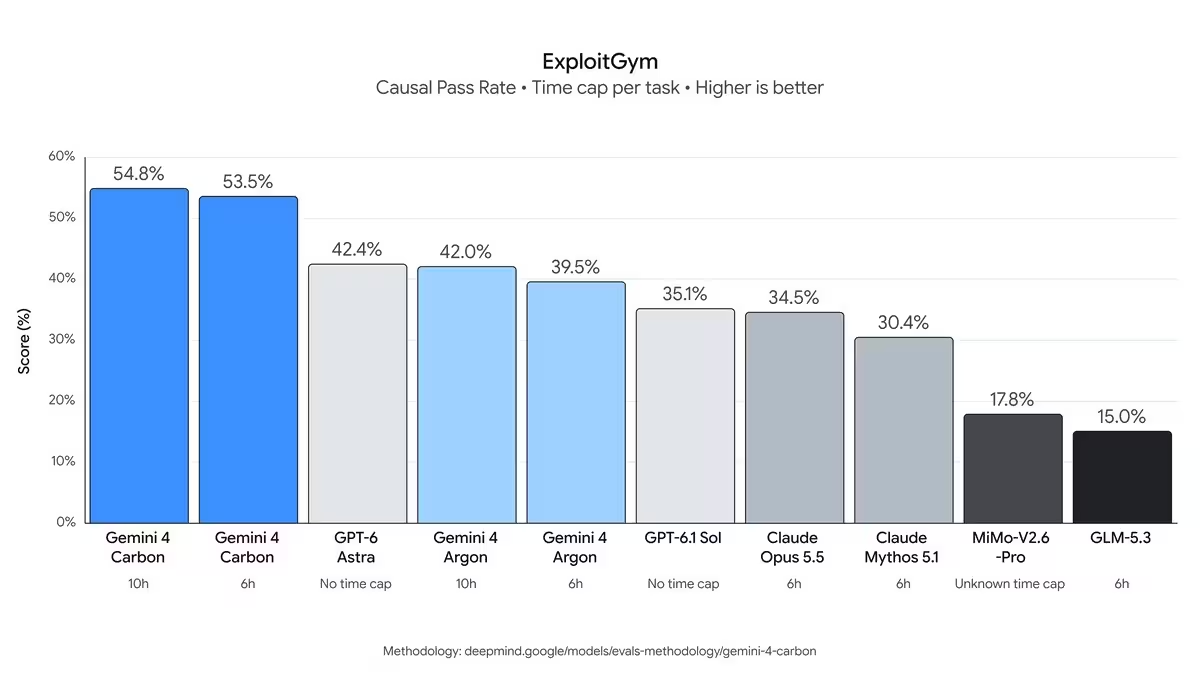
- Validation de l'exploitation : Carbon a obtenu 54,8 % sur ExploitGym, qui évalue la capacité d'un modèle à déterminer si une vulnérabilité est exploitable.
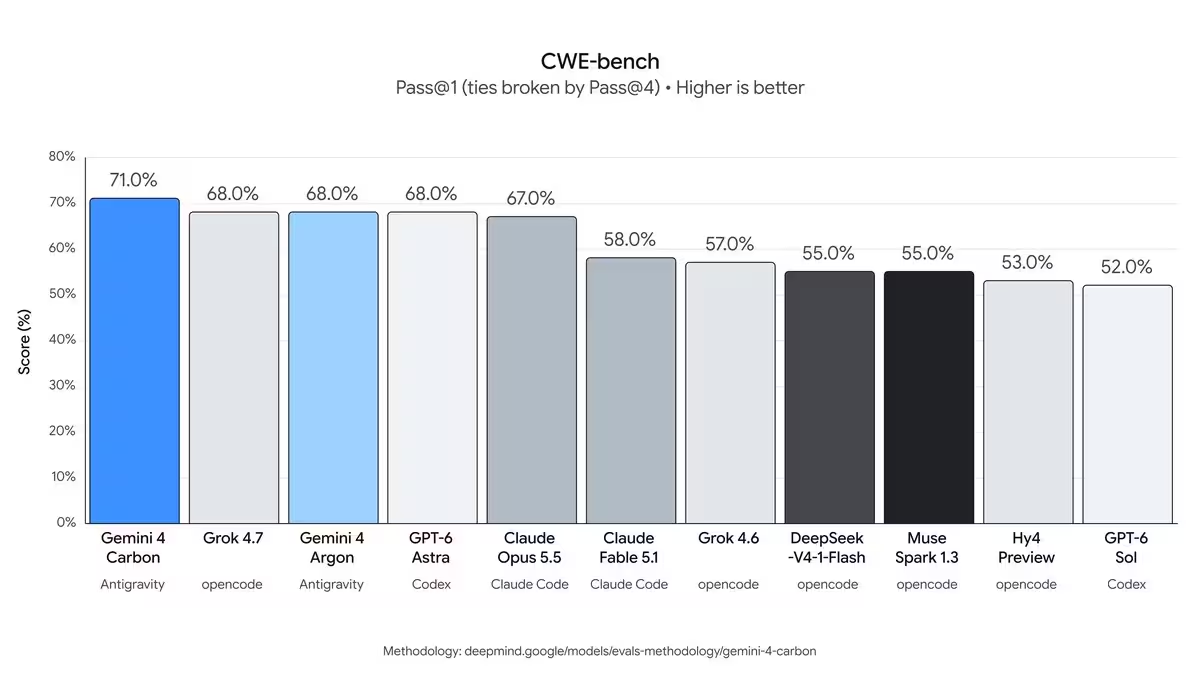
- Correction de la cause profonde : Carbon a obtenu 71 % sur CWE-bench de Collinear, en transformant des constats valides en correctifs exécutables.
Ces tests externes ont été menés sans couches de sécurité afin de mesurer les capacités brutes du modèle. Google précise toutefois que les déploiements en production intégreront des restrictions et des systèmes de détection des abus. Lors d'évaluations internes, le taux de réussite de Carbon dans la production de code sécurisé aurait été plus de deux fois supérieur à celui d'Argon. L'équipe Chrome a indiqué que Carbon générait des correctifs de meilleure qualité à un rythme plus de dix fois supérieur à celui d'un grand modèle non nommé provenant d'un autre laboratoire. Google n'a révélé ni le concurrent concerné ni la méthodologie complète des tests. La plateforme de sécurité Wiz a également constaté l'avantage de Carbon dans les métriques d'intrusion web utilisées dans son programme Scan for Good.
Architecture de sécurité, résistance aux injections de prompts et déploiement progressif
Google a appliqué à Carbon la même architecture défensive multicouche que celle utilisée pour Argon. Elle associe des contrôles lors de l'entraînement du modèle, des protections contre les abus en temps réel, une résistance aux injections de prompts et une surveillance des chaînes de raisonnement. Les objectifs d'entraînement visaient à empêcher le modèle de trouver des raccourcis lui permettant d'obtenir de bons scores sans résoudre le problème sous-jacent.
Dans les benchmarks de sécurité internes, Carbon a affiché un taux de réussite de triche de 0 % et un taux de tentative de triche de 0,4 % sur Terminal-Bench 4.0, tout en améliorant sa précision globale. Les environnements internes de programmation en direct ont fait état d'une baisse d'environ 80 % des alertes graves liées à des divergences comportementales. Les tests ont également montré que les affirmations non étayées ont chuté à environ la moitié du niveau observé avec Argon. Carbon peut récupérer des sources pertinentes avant d'agir et signaler les incohérences dans les données qu'il trouve. Google a fait état d'une baisse de 26 % des comportements hors périmètre et de 29 % des réponses faisant état d'un service insuffisant.
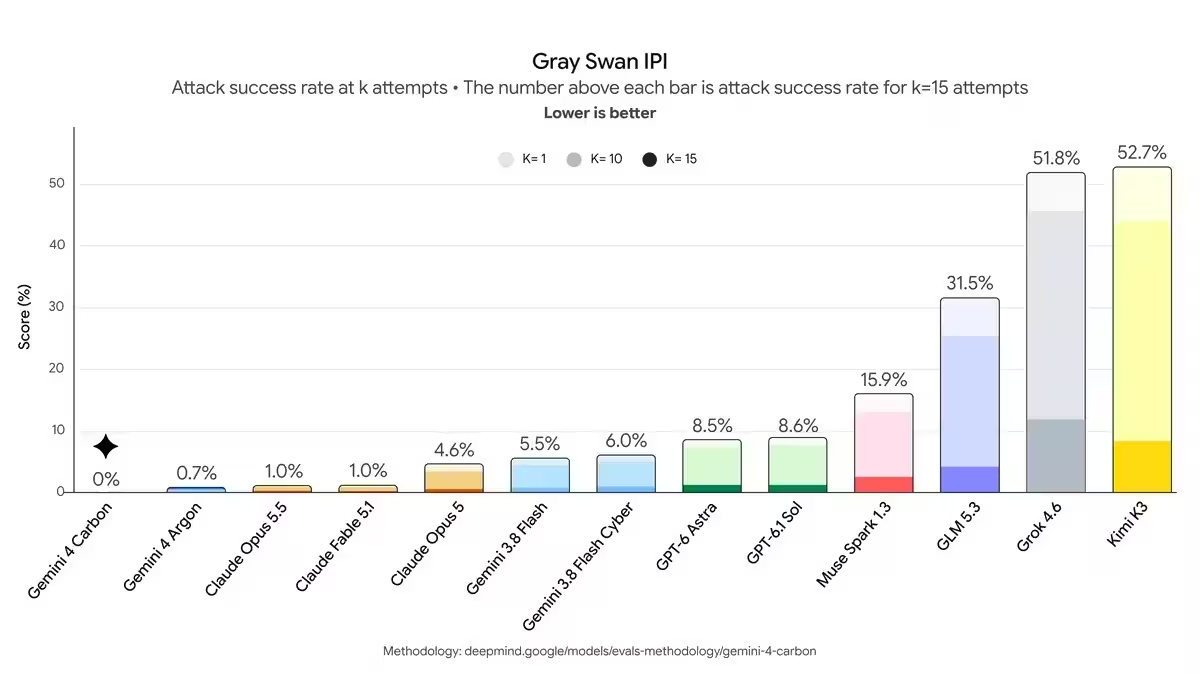
Carbon a affiché un taux de réussite de 0 % face aux attaques par injection indirecte de prompts dans le benchmark Gray Swan, contre 0,7 % pour Argon lors du même test. Google procède à un déploiement progressif et participe au processus volontaire américain de tests gouvernementaux. Un premier groupe de défenseurs de la cybersécurité y aura accès, avant une extension aux partenaires de confiance via le programme Fairwind. Les retours des testeurs serviront à affiner les mesures de protection. Google n'a communiqué aucun calendrier de disponibilité générale.
Tarification et modalités de facturation
Google a indiqué que Carbon adopterait le même tarif de lancement qu'Argon. Durant la période initiale, le traitement d'un million de tokens en entrée coûte 2 $ et la génération d'un million de tokens en sortie coûte 10 $. Les tokens d'entrée mis en cache bénéficient d'une réduction de 95 % par rapport au tarif des tokens d'entrée. Après la période de lancement, le coût des tokens d'entrée passera à 4 $ par million et celui des tokens de sortie à 20 $ par million. Google souligne que le coût final des projets agentiques de longue durée dépend d'autres facteurs que le seul tarif par token, notamment du nombre d'étapes, des appels aux outils, du volume de contexte et de l'utilisation du cache.

"Le code est ma langue maternelle. Je rédige des tutoriels et des guides pour les développeurs et les passionnés de tech."
Discussion
Laisser un commentaire
Commentaires
Aucun commentaire pour l'instant. Soyez le premier.