
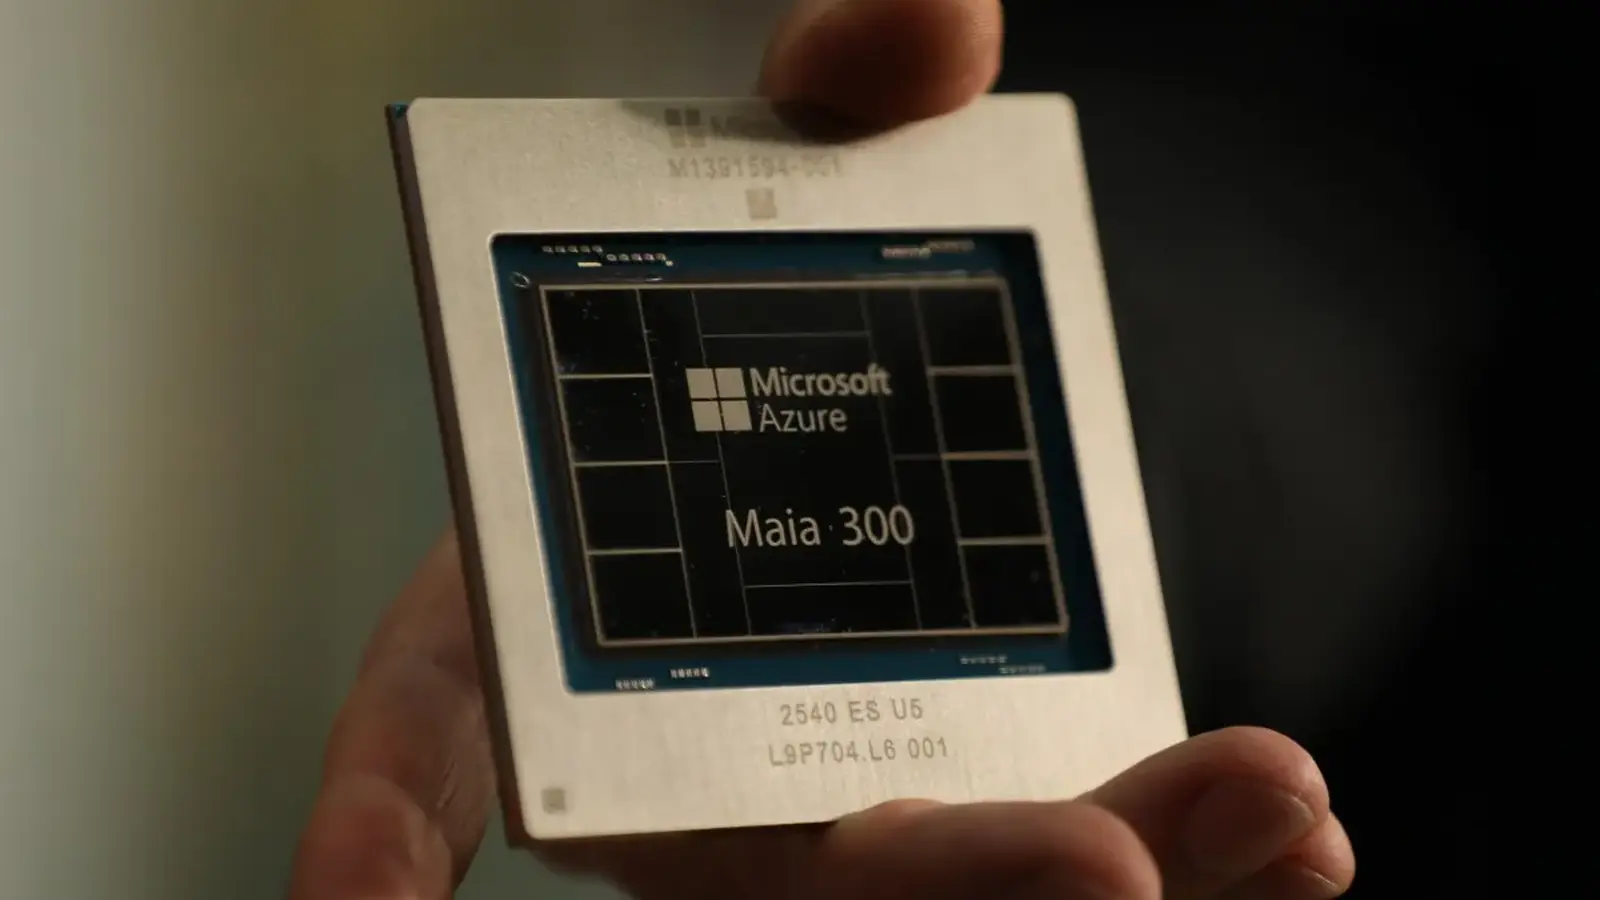
Microsoft a dévoilé Maia 300, sa puce d’inférence IA sur mesure de troisième génération. L’entreprise affirme que cette conception peut traiter environ 40 % de tokens supplémentaires par mégawatt par rapport aux principaux systèmes reposant sur des GPU. Microsoft présente Maia 300 comme un accélérateur d’inférence conçu pour devenir l’infrastructure d’inférence principale de ses produits et services.
Microsoft prévoit de mettre Maia 300 en production en 2027. Dans une déclaration, Scott Guthrie, vice-président exécutif du cloud chez Microsoft, a indiqué que ces améliorations permettront à l’entreprise de s’appuyer davantage sur ses propres puces sur mesure et de réduire sa dépendance à Nvidia et AMD. Il a ajouté que Microsoft commencera, dès 2027, à déployer la famille de puces Azure Maia à une échelle de plusieurs gigawatts, afin qu’elle puisse servir d’infrastructure d’inférence principale à l’échelle de l’entreprise.
Performances et rôle dans la pile technologique de Microsoft
Dans une configuration complète de 96 accélérateurs, Maia 300 peut multiplier par sept le débit de tokens au niveau du rack par rapport à Maia 200, la puce de génération précédente que Microsoft a présentée en janvier seulement. Maia 200 est déjà déployée pour diverses charges de travail de Microsoft, notamment Microsoft Copilot, GitHub Copilot, Microsoft Foundry et les modèles d’IA propriétaires de l’entreprise. Selon Scott Guthrie, Maia 200 demeure la meilleure infrastructure de calcul du parc Microsoft au regard des performances réelles des services d’IA, tandis que Maia 300 a été pensée comme un système complet pour les charges de travail d’IA de nouvelle génération.
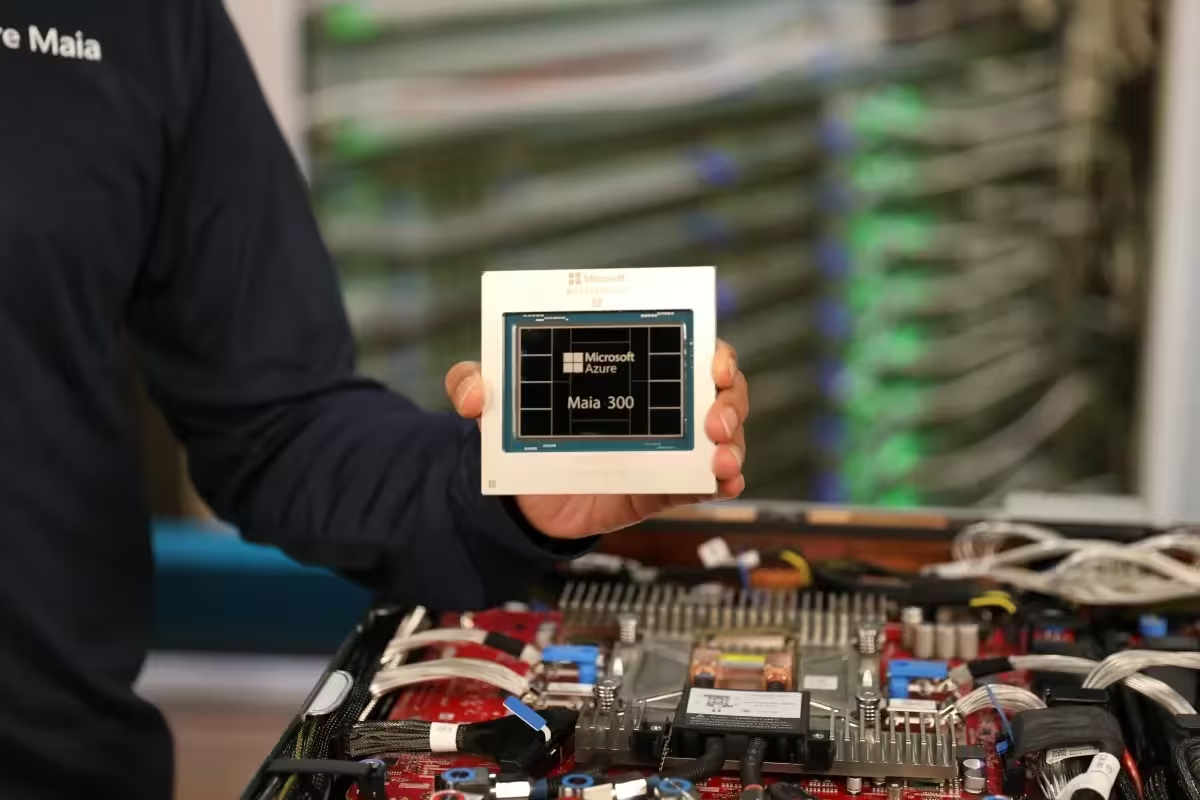
Microsoft décrit Maia 300 comme une puce optimisée pour les charges de travail de raisonnement à contexte long, les expériences conversationnelles à faible latence et les tâches d’agents continus en plusieurs étapes. L’entreprise précise que la puce vise l’inférence, et non l’entraînement des modèles.
Architecture de la puce et fabrication
Maia 300 repose sur une architecture en chiplets fabriquée selon le procédé N2P de TSMC. Microsoft indique que cette conception sépare les blocs de calcul, le contrôleur mémoire et les fonctions d’entrée-sortie, afin de consacrer davantage de surface de silicium au traitement et de permettre à chaque bloc d’utiliser une technologie adaptée à son rôle. L’équipe Azure chargée du matériel et de l’infrastructure estime que cette approche améliore l’efficacité et permet d’adapter la puce à des fonctions d’inférence spécifiques.
Microsoft indique également que Maia 300 jouera un rôle important dans ses projets de développement et de déploiement de ses propres modèles. Mustafa Suleyman, directeur général de Microsoft AI, a déclaré que l’entreprise doit développer toutes les couches de la pile technologique, des modèles au silicium, et qu’à l’échelle envisagée par Microsoft, une plateforme dédiée, conçue conjointement avec ses modèles, est indispensable. Il a ajouté que l’exécution des modèles propriétaires de Microsoft sur Maia constitue une priorité majeure pour l’équipe.

"Rédactrice spécialisée dans les réseaux sociaux et la culture web. Je suis les tendances qui font le buzz."
Discussion
Laisser un commentaire
Commentaires
Aucun commentaire pour l'instant. Soyez le premier.