

La mémoire devient discrètement le goulot d'étranglement dans la course à une inférence IA plus rapide. SK hynix vient de faire bouger les choses en envoyant des échantillons de son nouveau HBM4E à ses partenaires, augmentant la pression sur la bande passante mémoire dans la conception des accélérateurs.
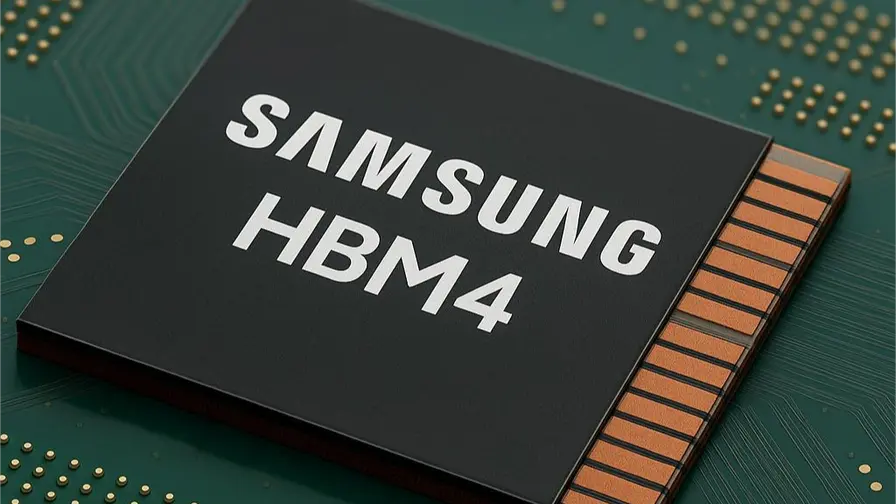
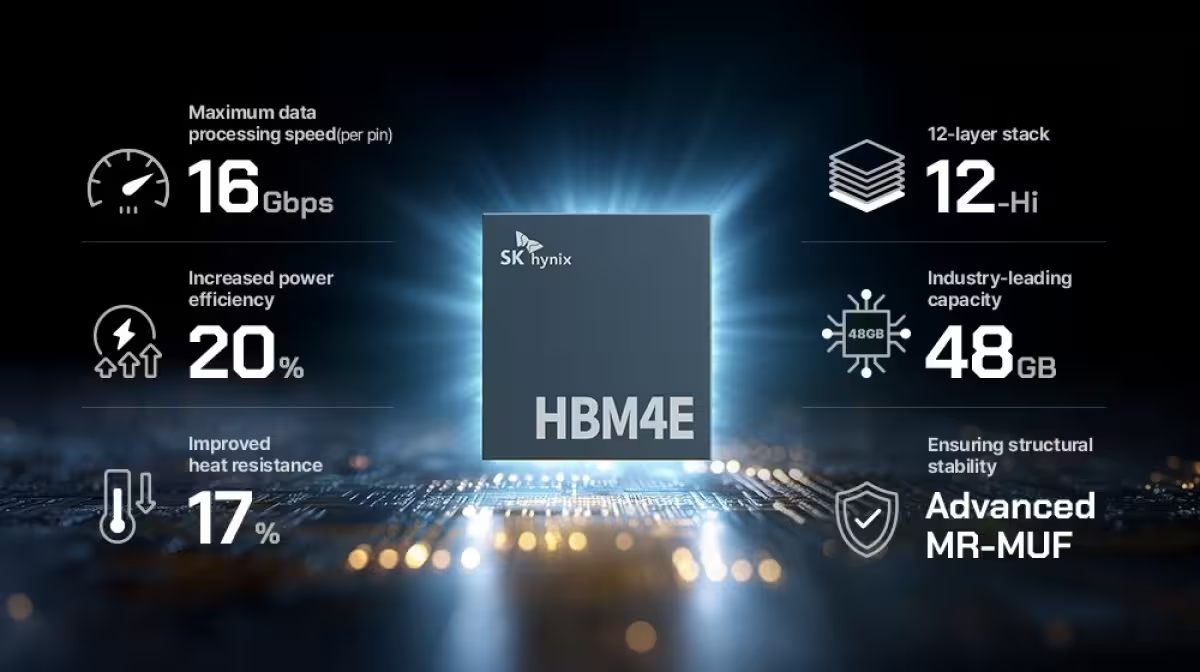
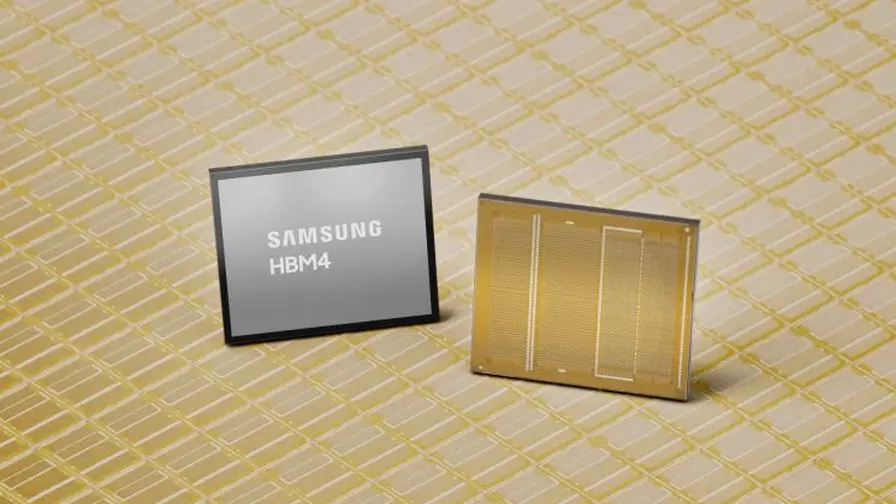
En bref : c'est plus rapide. Le HBM4E de SK hynix atteint 16 Gbps par broche, contre 10 Gbps dans la spécification HBM4 précédente. Samsung, pour ne pas être en reste, a commencé à distribuer des échantillons d'une conception à 14 Gbps environ un mois plus tôt, mais le saut de SK hynix est remarquable car les gains de performance s'accompagnent souvent de compromis douloureux. Pas cette fois.
Le HBM4E de SK hynix atteint 16 Gbps par broche et 48 Go par empilement de 12 dies.
L'entreprise empile 12 dies dans un même boîtier, ce qui donne 48 Go par empilement. Cela compte car la plupart des accélérateurs IA ne s'appuient pas sur un seul empilement ; ils relient plusieurs piles HBM pour alimenter d'immenses matrices sur puce. Plus de capacité par empilement simplifie la conception des cartes et réduit la complexité d'assemblage pour les modules d'accélération denses.
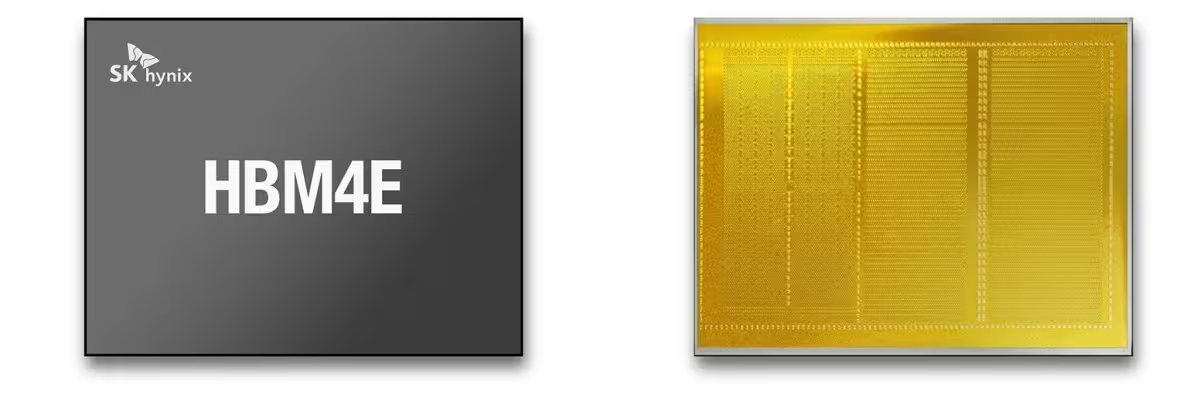
La consommation est l'endroit où cette génération fait une déclaration pragmatique. SK hynix affirme que le HBM4E est environ 20% plus économe en énergie que le HBM4 précédent. L'amélioration de l'efficacité est le héros discret de la déployabilité de l'IA - on peut ajouter de la bande passante, mais si l'on ne peut pas évacuer la chaleur, les gains pratiques disparaissent. SK hynix utilise un procédé Mass Reflow Molded Underfill (MR-MUF), injectant un liquide protecteur entre les dies en silicium pour stabiliser le boîtier. Le résultat : une résistance thermique inférieure d'environ 17% par rapport à l'approche antérieure, ce qui facilite le travail des systèmes de refroidissement.
Pourquoi la résistance thermique est-elle si importante ? Parce que dans un monde où les baies sont remplies d'accélérateurs, chaque watt économisé et chaque degré de température de jonction réduit augmentent la fiabilité et simplifient le budget de refroidissement des datacenters. Les ingénieurs détestent les surprises. Une résistance thermique plus faible est le type d'amélioration prévisible autour de laquelle ils peuvent bâtir des feuilles de route produit.
Les implications sont plus vastes. Des broches plus rapides et des empilements à plus haute densité permettent aux architectes de puces de repenser les agencements d'interposeurs et les canaux mémoire. Ils peuvent soit pousser le calcul brut plus loin, soit faire évoluer des modèles qui butaient auparavant contre les plafonds mémoire. En termes simples : des modèles plus grands, une inférence plus dense, ou les mêmes modèles tournant moins cher et plus frais.
SK hynix a présenté l'envoi des échantillons comme une étape réalisée selon le calendrier, soutenue par son expérience de production. Le message est clair - la société s'attend à ce que les partenaires entament les travaux de qualification et aillent vers la production de masse. Le timing importe pour les clients qui planifient des lancements de silicium et de modules ; l'accès anticipé aux échantillons raccourcit cette boucle.
Toutes les charges de travail IA n'ont pas besoin du dernier cri. Mais pour les hyperscalers et les startups matérielles IA en quête de débit maximal, la combinaison de bande passante, de capacité et de gains thermiques du HBM4E sera tentante. Réformera-t-elle la prochaine vague d'accélérateurs ? Peut-être. La question suivante est la rapidité avec laquelle l'écosystème - interposeurs, refroidisseurs et architectes système - s'adapte pour exploiter la marge que ces empilements offrent.
Si vous vous intéressez à l'avenir du matériel IA, gardez un œil sur la mémoire. Elle change souvent la donne sans faire beaucoup de bruit, jusqu'au jour où ce n'est plus le cas.

"Geek dans l'âme, je teste les derniers smartphones et gadgets pour vous aider à faire le meilleur choix."
Discussion
Laisser un commentaire
Commentaires
Aucun commentaire pour l'instant. Soyez le premier.