
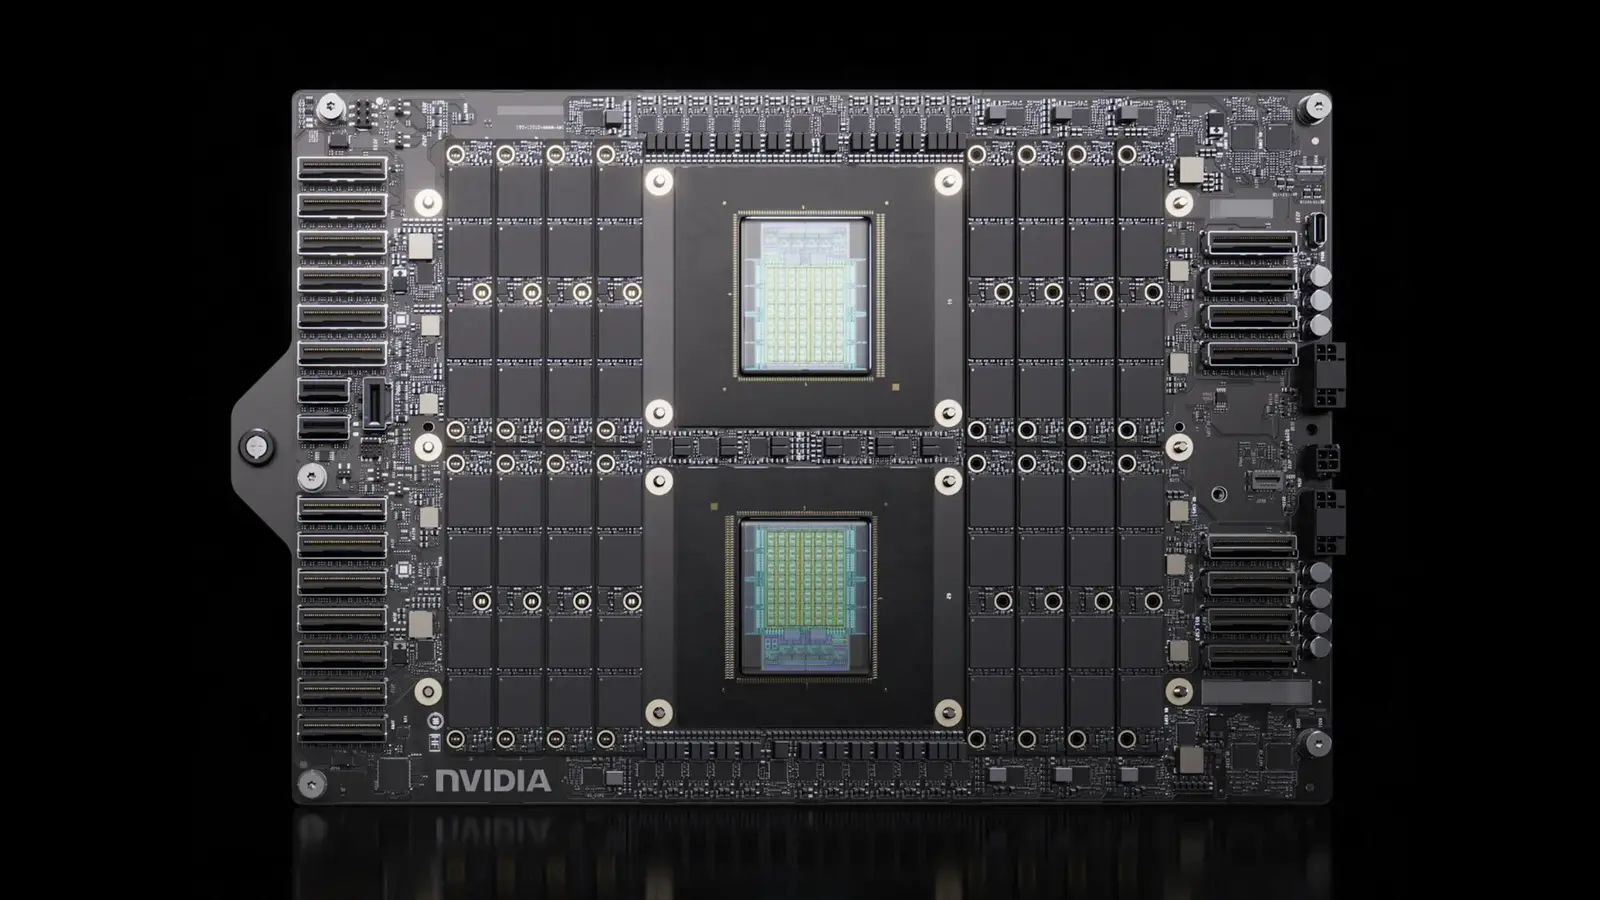
Les centres de données changent rarement du jour au lendemain. Mais lorsqu'ils évoluent, on remarque le bourdonnement. Les baies se densifient. La latence diminue. Les coûts sont réorganisés. Nvidia mise sur le fait que ce bourdonnement aura bientôt un nouveau nom : Vera.
Nvidia affirme que Vera offre environ 1,8 fois les performances des puces x86 leaders. Cette affirmation fait la une. Le matériel qui la soutient est l'élément déclencheur de la discussion. Vera est la moitié CPU de la plateforme Vera Rubin, associant un processeur ARM à un GPU Rubin pour les charges de travail qui nécessitent une très grande bande passante mémoire et une coordination étroite entre CPU et GPU.
Pourquoi Vera redéfinit la réflexion sur les serveurs IA
Vera est construite autour de 88 cœurs Olympus avec multithreading spatial, offrant 176 threads par socket. La mémoire n'est pas un élément secondaire : un seul processeur peut être associé à jusqu'à 1,5 téraoctets de LPDDR5X, fournissant environ 1,2 téraoctet par seconde de bande passante. Pour l'inférence et les modèles autonomes de l'IA qui consomment rapidement contexte et poids, cette bande passante est la mesure de survie.

Pensez à l'échelle. Nvidia a présenté une baie CPU Vera qui regroupe 256 processeurs dans un seul châssis. Cela équivaut à 22 528 cœurs et 45 056 threads. C'est le type de densité que recherchent les fournisseurs cloud lorsqu'ils tentent de déplacer de grands modèles hors des îlots coûteux réservés aux GPU et vers des architectures plus flexibles, orientées CPU.
Vera fonctionne aussi bien avec les GPU Rubin. La configuration NVL72 associe 36 processeurs Vera à 72 GPU Rubin, et Nvidia met en avant un interconnect NVLink-C2C à 1,8 téraoctet par seconde entre eux. L'objectif n'est pas de remplacer les GPU mais de réorganiser la relation hôte-accélérateur afin que les données circulent plus vite et que les logiciels rencontrent moins de goulets d'étranglement.
Les cas d'utilisation sont connus mais en expansion : IA agentive, apprentissage par renforcement, analyses intensives et inférence à grande échelle. Vera peut agir comme un nœud de calcul autonome pour ces tâches, ou comme l'hôte qui alimente et synchronise les GPU Rubin.

L'adoption est déjà en cours. Anthropic, OpenAI et SpaceXAI se sont engagés sur la plateforme pour leurs charges de modèles, et des hyperscalers tels que ByteDance, CoreWeave et Oracle Cloud Infrastructure sont à bord. Côté systèmes, Dell, HP, Lenovo et Supermicro proposeront des serveurs basés sur Vera. De grands fabricants, dont Asus, Compal, Foxconn, Gigabyte, Pegatron, Quanta Cloud Technology, Wistron et Wiwynn, produiront du matériel centré sur la puce.
Même des clients non traditionnels y prêtent attention. La Bourse de New York (New York Stock Exchange), qui traite environ 1,1 trillion de messages par jour, explore Vera avec les partenaires Redpanda et HP pour repenser les infrastructures sensibles à la latence. Ce type d'intérêt montre que la plateforme est évaluée pour plus que l'entraînement de modèles : on la considère pour des systèmes en temps réel à haut débit où chaque microseconde compte.
Pour Nvidia, Vera étend une feuille de route familière : tirer les enseignements des déploiements IA centrés sur le GPU et les appliquer à la conception CPU. La société a précédemment intégré son travail sur l'IA dans des produits comme RTX Spark, qui a mis en lumière les CPU Grace et les GPU Blackwell avec mémoire LPDDR5X. Maintenant, la conversation s'est déplacée de la performance GPU mono-nœud vers l'équilibre et le débit au niveau du système.
Vera va-t-elle détrôner x86 dans le centre de données ? Pas du jour au lendemain. Mais l'architecture cible des points douloureux spécifiques pour les charges IA : la bande passante mémoire, la densité de threads et l'interconnect rapide CPU-GPU. Pour les ingénieurs et les architectes qui s'efforcent de maîtriser les coûts et le débit des modèles, c'est un début concret.

"Geek dans l'âme, je teste les derniers smartphones et gadgets pour vous aider à faire le meilleur choix."
Discussion
Laisser un commentaire
Commentaires
Aucun commentaire pour l'instant. Soyez le premier.